จากตอนที่แล้ว เรารู้แล้วว่าเมื่อเราเตรียมข้อมูลนำเข้าที่เรียกว่า Prompt ยื่นไปให้กล่องดำที่เรียกว่า Model (สมองกล) ตัวสมองกลก็มีหน้าที่ก้มหน้าก้มตาสร้างคำตอบกลับมาให้เรา
แต่ก่อนที่ข้อมูลก้อนนั้น จะหลุดเข้าไปถึงตัวสมองกลจริง ๆ... มีเรื่องจริงอีกเรื่องหนึ่งที่พวกเราต้องรู้ไว้ครับ:
คอมพิวเตอร์และสมองกล AI... อ่านตัวหนังสือเป็นคำ ๆ แบบที่ตามนุษย์เรามองเห็นไม่เป็นเลยครับ!
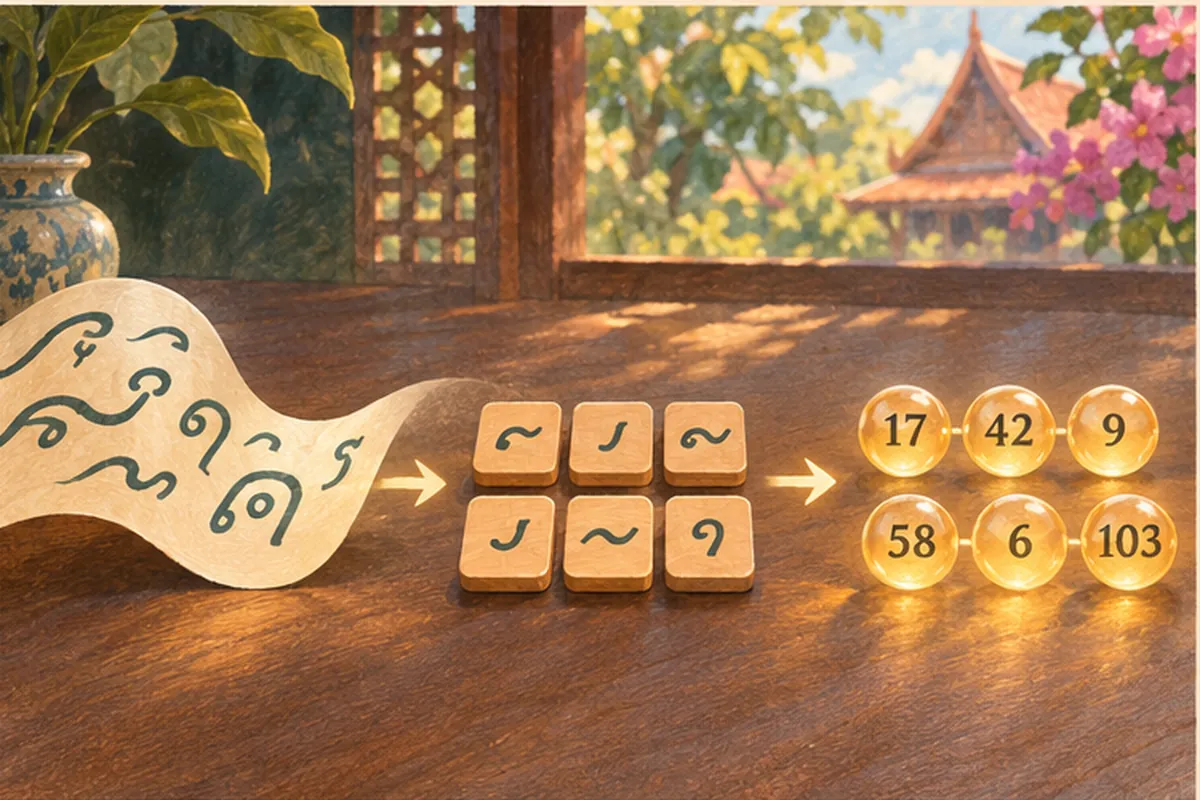
ข้างในระบบคอมพิวเตอร์ มันทำงานด้วยรหัสตัวเลขและการคำนวณทางคณิตศาสตร์ หน้าประตูห้องเครื่องของสมองกล จึงต้องมี "ตัวตัดข้อความ" (Tokenizer) ประจำการอยู่ตรงด่านหน้า
ชิ้นข้อความที่เรียกว่า "Token"
หน้าที่ของตัวตัดข้อความด่านหน้านี้เรียบง่ายมากครับ:
- ขาเข้า: รับข้อความของเรามา แล้วจับ "หั่นเป็นชิ้นเล็ก ๆ" จากนั้นแปลงแต่ละชิ้นให้กลายเป็นรหัสตัวเลขส่งเข้าปากสมองกล
- ขาออก: พอสมองกลประมวลผลคำตอบเสร็จเป็นรหัสตัวเลข มันก็ส่งรหัสตัวเลขนั้นกลับมาให้ตัวตัดข้อความช่วยแปลงกลับคืนมาเป็นข้อความภาษาคนให้อ่านบนจอ
ไอ้เจ้า "ชิ้นข้อความที่โมเดลใช้ประมวลผล" แต่ละชิ้นนี่แหละครับ... ในวงการเขาเรียกมันว่า Token (โทเคน)
ถ้าจะเปรียบเทียบให้เห็นภาพในชีวิตประจำวันที่สุด:
Token ก็เปรียบเหมือน "ตัวเลขบนมิเตอร์" ที่คอยนับจำนวนชิ้นข้อความที่ระบบรับเข้าและสร้างออกไปในแต่ละรอบครับ!
จำนวนชิ้นข้อความ (Token) ที่ระบบรับเข้าและสร้างออกไปนี้ มันส่งผลต่อพวกเราโดยตรงใน 2 มิติสำคัญ:
- พื้นที่บริบทบนโต๊ะทำงาน: สมองกลแต่ละตัว มีขีดจำกัดว่าในแต่ละรอบ มันรับเอกสารเข้ามาอ่านบนโต๊ะทำงานได้กี่ Token ถ้าเนื้อหาที่เราส่งไปรวมกับคำตอบที่จะสร้างมีจำนวนชิ้นข้อความมากเกินไป โต๊ะทำงานก็จะเต็ม
- ค่าบริการตามเงื่อนไขของผู้ให้บริการ: ผู้ให้บริการแต่ละรายมักคิดค่าบริการโดยอิงจากจำนวนโทเคนที่ระบบรับเข้าและสร้างออกไปตามเงื่อนไขและราคาของโมเดลรุ่นนั้น ๆ (เช่น บางรายคิดราคาโทเคนขาเข้ากับขาออกต่างกัน หรือมีโควตาใช้งานฟรีตามระดับการใช้งาน)
ไม่ต้องเจาะลึกไส้ใน... ถ้าต้องคุมงบ ให้ลองนับด้วยเครื่องมือ
หลายคนพอเริ่มศึกษาเรื่องนี้ ก็มักจะพยายามไปเปิดตำราดูว่ามันหั่นคำด้วยสูตรคณิตศาสตร์อะไร ตัดคำตรงไหน...
ถ้าถามผมในฐานะคนทำระบบ เราไม่ต้องไปนั่งเจาะลึกกลไกการหั่นคำข้างในให้เสียเวลาหรอกครับ เพราะสุดท้ายระบบของผู้ให้บริการก็เป็นคนนับมิเตอร์นั้นอยู่ดี
สิ่งสำคัญในทางปฏิบัติจริง ๆ มีแค่ข้อเดียวครับ: ถ้าเราจำเป็นต้องวางแผนควบคุมงบประมาณ หรืออยากรู้ว่าเนื้อหาของเราจะใช้กี่ Token... ทางที่ดีที่สุดคือให้ลองเอาข้อความไปนับด้วย "เครื่องมือนับโทเคน" (Token Counter) ของโมเดลรุ่นที่เราจะเลือกใช้ได้เลยครับ! นั่นคือวิธีที่แม่นยำและเห็นตัวเลขจริงที่สุดแล้ว
ข้อความภาษาไทย กับภาษาอังกฤษ
อีกเรื่องหนึ่งที่มีคนพูดถึงกันบ่อย คือเรื่องความต่างระหว่างภาษาไทยกับภาษาอังกฤษ:
ในเนื้อหาใจความเดียวกัน... ข้อความภาษาไทยในโมเดลบางรุ่นอาจใช้จำนวน Token มากกว่าภาษาอังกฤษ ทั้งนี้ขึ้นอยู่กับตัวตัดข้อความ (Tokenizer) ของแต่ละโมเดลครับ
ที่เห็นเป็นแนวโน้มเช่นนี้ เพราะโมเดลภาษาและตัวตัดข้อความส่วนใหญ่ในโลก ถูกพัฒนาและฝึกฝนด้วยภาษาอังกฤษเป็นหลัก ทำให้การตัดคำภาษาอังกฤษมักจะทำได้กระชับกว่า
ในขณะที่ภาษาไทย ซึ่งมีโครงสร้างสระ วรรณยุกต์ และการเขียนคำติดต่อกันโดยไม่มีการเว้นวรรค ตัวตัดข้อความของบางโมเดลอาจต้องซอยข้อความภาษาไทยออกเป็นชิ้นย่อย ๆ มากกว่าภาษาอังกฤษสำหรับใจความที่เทียบเคียงกัน
(แม้ว่าในปัจจุบัน โมเดลรุ่นใหม่ ๆ หลายตัวจะเริ่มพัฒนาตัวตัดข้อความให้รองรับภาษาไทยได้กระชับขึ้นเรื่อย ๆ แล้ว แต่แนวโน้มนี้ก็ยังเป็นสิ่งที่คนทำงานกับภาษาไทยควรทราบไว้ครับ)
ดังนั้น ในการวางแผนระบบ ไม่ว่าจะเป็นเรื่องขนาดพื้นที่ทำงาน หรือการประเมินค่าบริการ การคำนึงถึงแนวโน้มที่โมเดลบางรุ่นอาจใช้จำนวน Token ภาษาไทยมากกว่า ก็จะช่วยให้เราบริหารจัดการระบบได้อย่างรอบคอบขึ้นครับ
สรุปบทเรียน: รู้จัก Token แบบคนทำงาน
เห็นไหมครับว่า พอเรามอง Token เป็น "ชิ้นข้อความที่โมเดลใช้ประมวลผล" และเปรียบเหมือนตัวเลขบนมิเตอร์ที่คอยนับข้อมูลเข้า-ออก ทุกอย่างก็เข้าใจได้ง่ายมาก:
- เราไม่ต้องไปนั่งเครียดกับสูตรการตัดคำ
- ถ้าต้องคุมงบ ให้ใช้เครื่องมือนับโทเคนของรุ่นนั้นเป็นตัวเช็ก
- จำนวน Token ผูกกับพื้นที่โต๊ะทำงาน และค่าบริการขึ้นอยู่กับเงื่อนไขของผู้ให้บริการแต่ละราย
แต่หลังจากที่ตัวตัดข้อความ หั่นข้อความเป็น Token ส่งเข้าไปให้สมองกลประมวลผลจนได้คำตอบเสร็จสิ้นแล้ว...
มีอีกหนึ่งความจริงที่น่าสนใจเกี่ยวกับเจ้าสมองกลนี้ครับ:
เมื่อประมวลผลเสร็จแล้ว... มันเก็บเรื่องราวที่เพิ่งตอบไปไว้ในความทรงจำบ้างไหม?
ถ้าวันพรุ่งนี้เรากลับมาคุยต่อ ทำไมระบบถึงคุยเรื่องเดิมได้?
เราจะตามไปดูหน้าที่ที่แท้จริงของสมองกล และทำความเข้าใจคำว่า "ไร้สถานะ" (Stateless) พร้อมกันในตอนต่อไปครับ!
ศัพท์เทคนิค → คำแปลภาษาคนทำงาน — แตะเพื่อย่อ/ขยาย
- Token (โทเคน): ชิ้นข้อความที่โมเดลใช้ในการประมวลผล เปรียบเหมือนตัวเลขบนมิเตอร์ที่ใช้วัดปริมาณข้อมูลที่ระบบรับเข้าและสร้างออกไปในแต่ละรอบ
- Tokenizer (ตัวตัดข้อความ): โปรแกรมด่านหน้าที่ทำหน้าที่แปลงข้อความภาษาคน ให้กลายเป็นชิ้นโทเคนเพื่อส่งเข้าโมเดล และแปลงกลับมาเป็นภาษาคนเมื่อตอบเสร็จ
หลักคิดเชิงสถาปัตยกรรม — แตะเพื่อย่อ/ขยาย
- ตรวจเช็กด้วยเครื่องมือนับจริง: สถาปนิกและคนทำงานจริงจะไม่เสียเวลาคาดเดาสูตรการหั่นคำ แต่จะใช้เครื่องมือนับโทเคนของผู้ให้บริการรุ่นนั้น ๆ เพื่อตรวจสอบขนาดและประเมินงบประมาณจริง
- แนวโน้มโทเคนภาษาไทย: ข้อความภาษาไทยในโมเดลบางรุ่นอาจใช้จำนวนโทเคนมากกว่าภาษาอังกฤษสำหรับใจความที่เทียบเคียงกัน ขึ้นอยู่กับตัวตัดข้อความของโมเดลแต่ละค่าย สถาปนิกจึงต้องคำนึงถึงแนวโน้มนี้ในการคำนวณขนาดบริบทและค่าบริการตามเงื่อนไขของผู้ให้บริการครับ